
Pourquoi les coûts LLM dérapent si vite ?
Les coûts LLM dérapent surtout parce qu’on voit les totaux trop tard, sans savoir quelle feature, quelle équipe, quel prompt ou quel modèle a consommé quoi.
Le prix par token, c’est la partie visible. Oui, un modèle plus cher coûte plus cher à chaque appel. Mais dans la vraie vie, la facture double rarement à cause d’un seul paramètre. Elle double parce que tout bouge en même temps, souvent sans validation claire.
J’ai déjà vu ça chez un client avec une fonctionnalité de support IA. Au début, ça avait l’air propre. Quelques appels API, des réponses courtes, un modèle pas trop cher. Puis l’équipe a ajouté le contexte client pour améliorer la qualité. Ensuite, les réponses sont devenues plus longues. Puis on a gardé plus d’historique dans le prompt. Puis les retries ont augmenté quand l’API répondait lentement. Résultat : le coût par ticket a explosé, alors que le volume utilisateur n’avait pas vraiment explosé.
Le piège, c’est que chaque changement paraît raisonnable isolément. Ajouter trois messages d’historique, ce n’est pas dramatique. Passer sur un modèle plus puissant pour 20% des cas, ça se défend. Relancer une requête qui échoue, c’est normal. Mais quand tout s’empile, vous ne payez plus une réponse IA. Vous payez une chaîne complète d’appels, de contexte, de retries et parfois de boucles d’agents qui repartent toutes seules sans limite nette.
Sans attribution par requête, on pilote à l’aveugle. Les dashboards fournisseurs sont utiles, je ne vais pas dire le contraire. Ils donnent une vision globale, par jour, par modèle, parfois par clé API. Mais pour gérer un vrai budget produit, ce n’est pas assez fin. Il faut savoir :
- Quelle fonctionnalité consomme.
- Quelle équipe a déclenché la dépense.
- Quel prompt grossit avec le temps.
- Quel modèle est appelé sans raison valable.
- Quelle boucle agent relance trop d’appels.
Sinon, la discussion arrive trop tard. La facture a doublé, personne n’a “validé” une hausse, et pourtant le système l’a créée tout seul.
| Facteur | Effet sur la facture | Signal à surveiller |
| Volume d’appels API | Multiplie mécaniquement les coûts, même avec un modèle peu cher. | Nombre d’appels par utilisateur, par feature et par jour. |
| Choix du modèle | Fait varier fortement le coût pour une même tâche. | Répartition des appels entre petits et gros modèles. |
| Longueur des réponses | Augmente les tokens générés, souvent sans gain métier clair. | Tokens de sortie moyens par cas d’usage. |
| Contexte accumulé | Gonfle chaque requête avant même que le modèle réponde. | Tokens d’entrée moyens et taille des prompts. |
| Retries et boucles d’agents | Relance des appels invisibles pour l’utilisateur, mais bien facturés. | Taux de retry, profondeur des boucles et appels par tâche. |
Quelles données faut-il taguer ?
Je tague chaque requête LLM avec assez de contexte pour relier la dépense à un usage business précis. Pas juste “on a consommé 4 millions de tokens”, ça ne sert à rien. Je veux savoir quelle app, quelle feature, quelle équipe, quel workflow, et pour quel résultat.
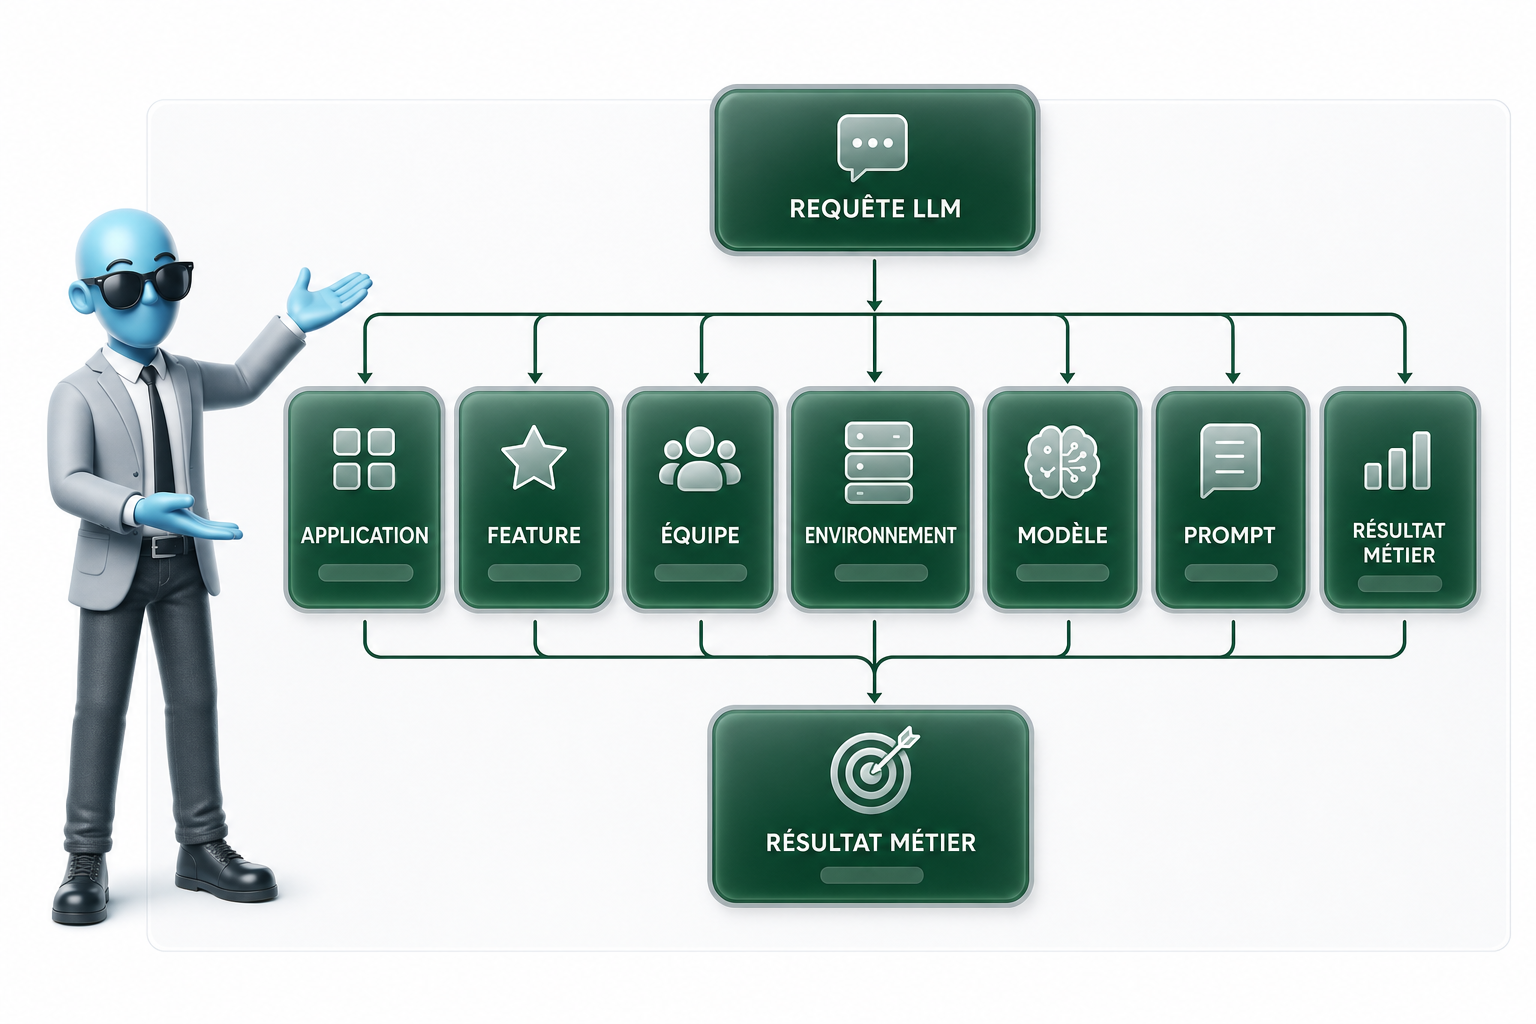
Les dimensions que je garde presque toujours sont simples. Elles permettent de découper la facture sans refaire une enquête à chaque fin de mois.
- Application : Le produit ou service qui déclenche l’appel.
- Feature : La fonctionnalité précise, par exemple résumé, extraction, classification, support client.
- Équipe propriétaire : Le owner métier ou tech responsable du budget et des choix.
- Environnement : Production, staging, dev. Les coûts de test peuvent vite polluer l’analyse.
- Utilisateur ou segment : Pas forcément l’ID brut, parfois un segment suffit, comme free, premium, interne.
- Modèle, fournisseur et déploiement : OpenAI, Azure OpenAI, Anthropic, proxy interne, région, endpoint.
- Version du prompt : Indispensable pour comprendre pourquoi un coût change après une modification.
- Type de tâche : Chat, extraction, RAG, agent, génération, modération, analyse documentaire.
- Statut, retry, cache hit ou miss : Pour séparer le coût utile du coût subi.
- Agent ou workflow déclencheur : Très utile dès qu’on a des chaînes automatiques qui appellent plusieurs modèles.
Côté métriques, je sépare les tokens d’entrée, les tokens de sortie, les tokens de cache, et les éventuels tokens de raisonnement si le modèle les expose. J’ajoute le nombre d’appels, la latence, les erreurs, les retries, le coût estimé par appel, le coût par tâche et surtout le coût par résultat utile. C’est souvent là que la vérité sort.
L’objectif n’est pas de tout stocker pour faire joli dans un dashboard. L’objectif c’est de répondre vite à trois questions : qui consomme, pourquoi ça consomme, et est-ce que la valeur produite justifie le coût.
Chez des clients, le plus gros gain vient souvent d’un simple champ owner ou feature_name ajouté dans les logs. Ça transforme une facture floue en discussion produit claire. D’un coup, on ne parle plus “d’IA trop chère”, on parle d’une feature précise qui coûte 800 euros pour générer 40 dossiers exploitables.
Voici une structure générique que j’aime bien. Elle marche avec OpenAI, Azure OpenAI, Anthropic, un proxy LLM ou une plateforme d’observabilité, parce qu’elle ne dépend d’aucun SDK spécifique.
{
  "request_id": "req_123",
  "timestamp": "2026-09-21T10:15:30Z",
  "application": "customer_support",
  "feature_name": "ticket_summary",
  "owner": "support_ops",
  "environment": "production",
  "user_segment": "premium",
  "provider": "generic_llm_provider",
  "model": "model-name",
  "deployment": "eu-west-production",
  "prompt_version": "summary_prompt_v4",
  "task_type": "summarization",
  "workflow_name": "support_triage_agent",
  "status": "success",
  "retry_count": 0,
  "cache_status": "miss",
  "input_tokens": 1840,
  "output_tokens": 320,
  "cache_tokens": 0,
  "reasoning_tokens": 0,
  "latency_ms": 1420,
  "estimated_cost_usd": 0.0124,
  "business_result": "summary_created"
}
Comment faire un audit LLM en 30 minutes ?
Un audit LLM rapide consiste à récupérer les logs, normaliser les coûts, segmenter les tokens, attribuer les usages et isoler les vrais moteurs de dépense.
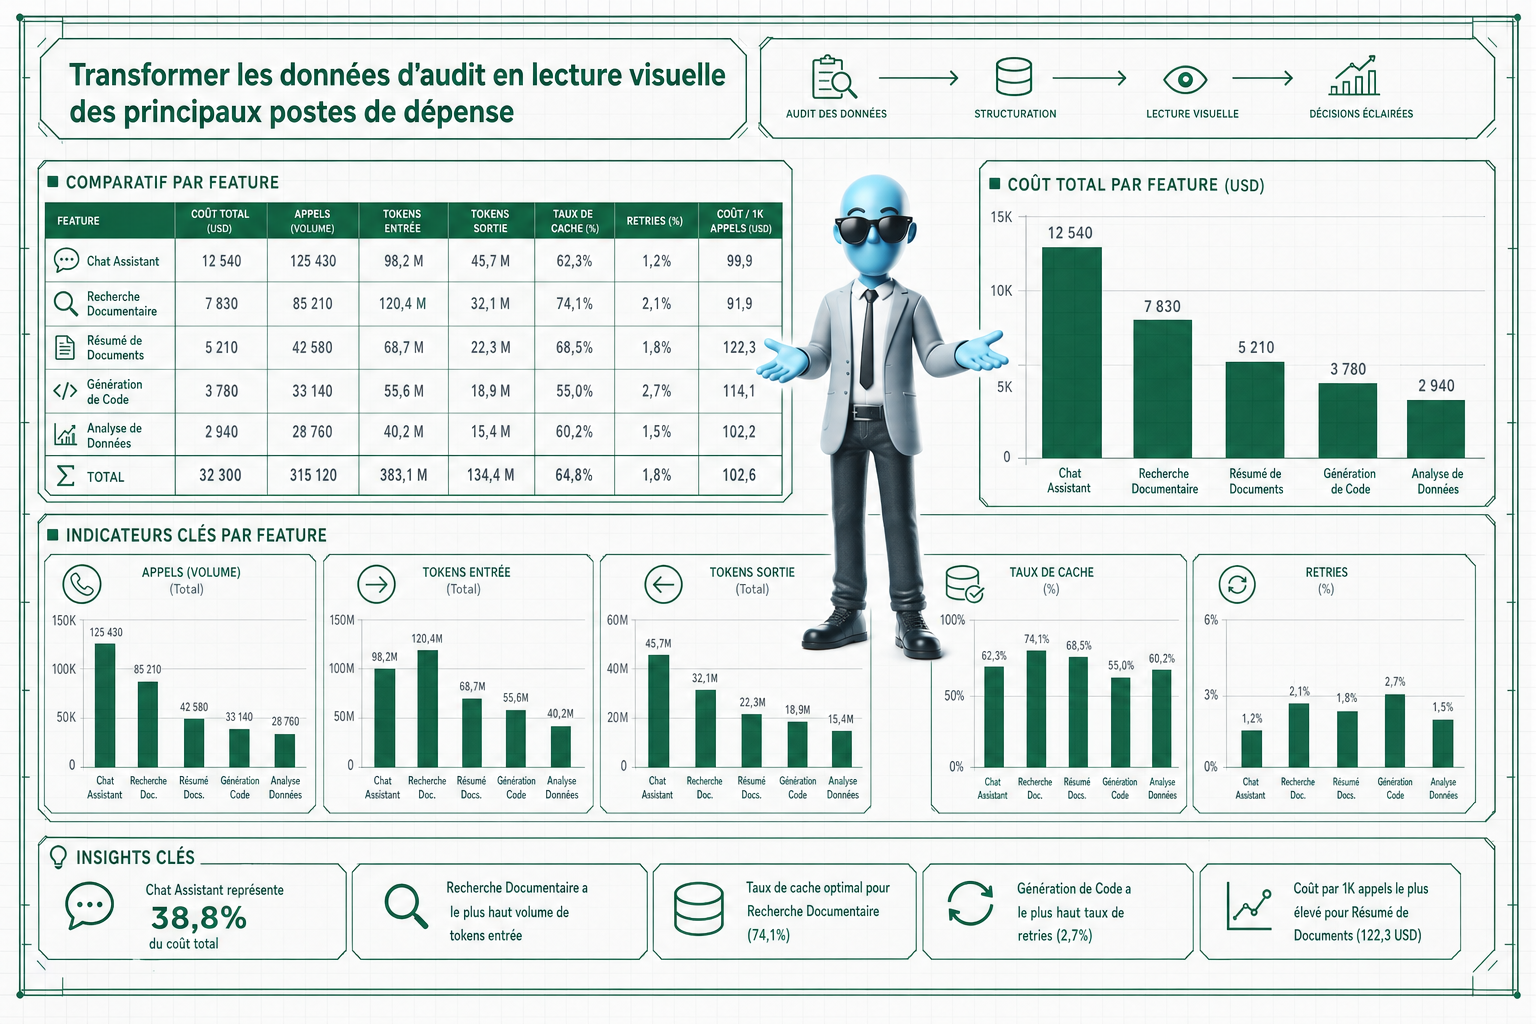
Je commence simple. Je prends ce qui existe déjà : dashboards fournisseurs, logs applicatifs, proxy LLM, outil d’observabilité type Langfuse, Helicone ou Datadog. Même un export CSV moche suffit souvent pour voir les dégâts. Chez un client, on a trouvé en 20 minutes qu’une seule feature de résumé consommait plus que tout le reste du produit.
Ensuite je nettoie. Même modèle écrit avec trois noms différents, prix en dollars pour 1M tokens, environnement prod ou staging mélangé, feature absente… Si on ne normalise pas ça, l’audit raconte n’importe quoi.
- Je sépare les tokens d’entrée, les tokens de sortie, les tokens en cache et les tokens spécifiques quand le fournisseur les expose.
- J’attribue chaque ligne à une équipe, un produit, une feature ou une tâche métier.
- Je calcule le coût par tâche, par utilisateur actif, par conversation ou par résultat utile.
Les vrais moteurs sautent vite aux yeux : modèle haut de gamme utilisé par défaut, prompts trop longs, sorties non bornées, contextes cumulés à chaque tour, retries anormaux, agents qui tournent en boucle, mauvais taux de cache, ou pic isolé sur une seule feature.
| Feature | Modèle | Appels | Tokens entrée | Tokens sortie | Cache | Retries | Coût estimé | Action recommandée |
| Résumé ticket | premium-large | 12 400 | 48M | 9M | 8% | 14% | 620€ | Réduire prompt, passer sur modèle moyen |
| Chat support | medium | 31 000 | 22M | 18M | 42% | 3% | 410€ | Limiter sortie, garder cache |
Pour agréger vite, j’utilise une logique neutre fournisseur. Ce code sert quand les logs ont déjà des colonnes génériques.
import pandas as pd

# Charge un export de logs LLM générique
df = pd.read_csv("llm_logs.csv")

# Calcule le coût entrée + sortie, puis retire une remise cache si elle existe
df["input_cost"] = df["input_tokens"] / 1_000_000 * df["price_input_per_million"]
df["output_cost"] = df["output_tokens"] / 1_000_000 * df["price_output_per_million"]
df["cache_discount"] = df["cache_tokens"] / 1_000_000 * df.get("price_cache_discount_per_million", 0)

df["estimated_cost"] = df["input_cost"] + df["output_cost"] - df["cache_discount"]

# Agrège par feature et modèle pour repérer les gros postes
audit = (
    df.groupby(["feature", "model"], as_index=False)
      .agg({
          "request_id": "count",
          "input_tokens": "sum",
          "output_tokens": "sum",
          "cache_tokens": "sum",
          "retries": "sum",
          "estimated_cost": "sum"
      })
      .rename(columns={"request_id": "calls"})
      .sort_values("estimated_cost", ascending=False)
)

print(audit.head(20))
Un audit de 30 minutes ne remplace pas une démarche FinOps complète, avec budgets, alertes, ownership et optimisation continue. Mais il donne déjà la carte des incendies. Et souvent, c’est exactement ce qu’il faut pour arrêter de brûler du cash à l’aveugle.
Quels outils choisir selon votre budget ?
L’outil dépend surtout du niveau de dépense LLM, du besoin d’attribution et de la maturité de monitoring.
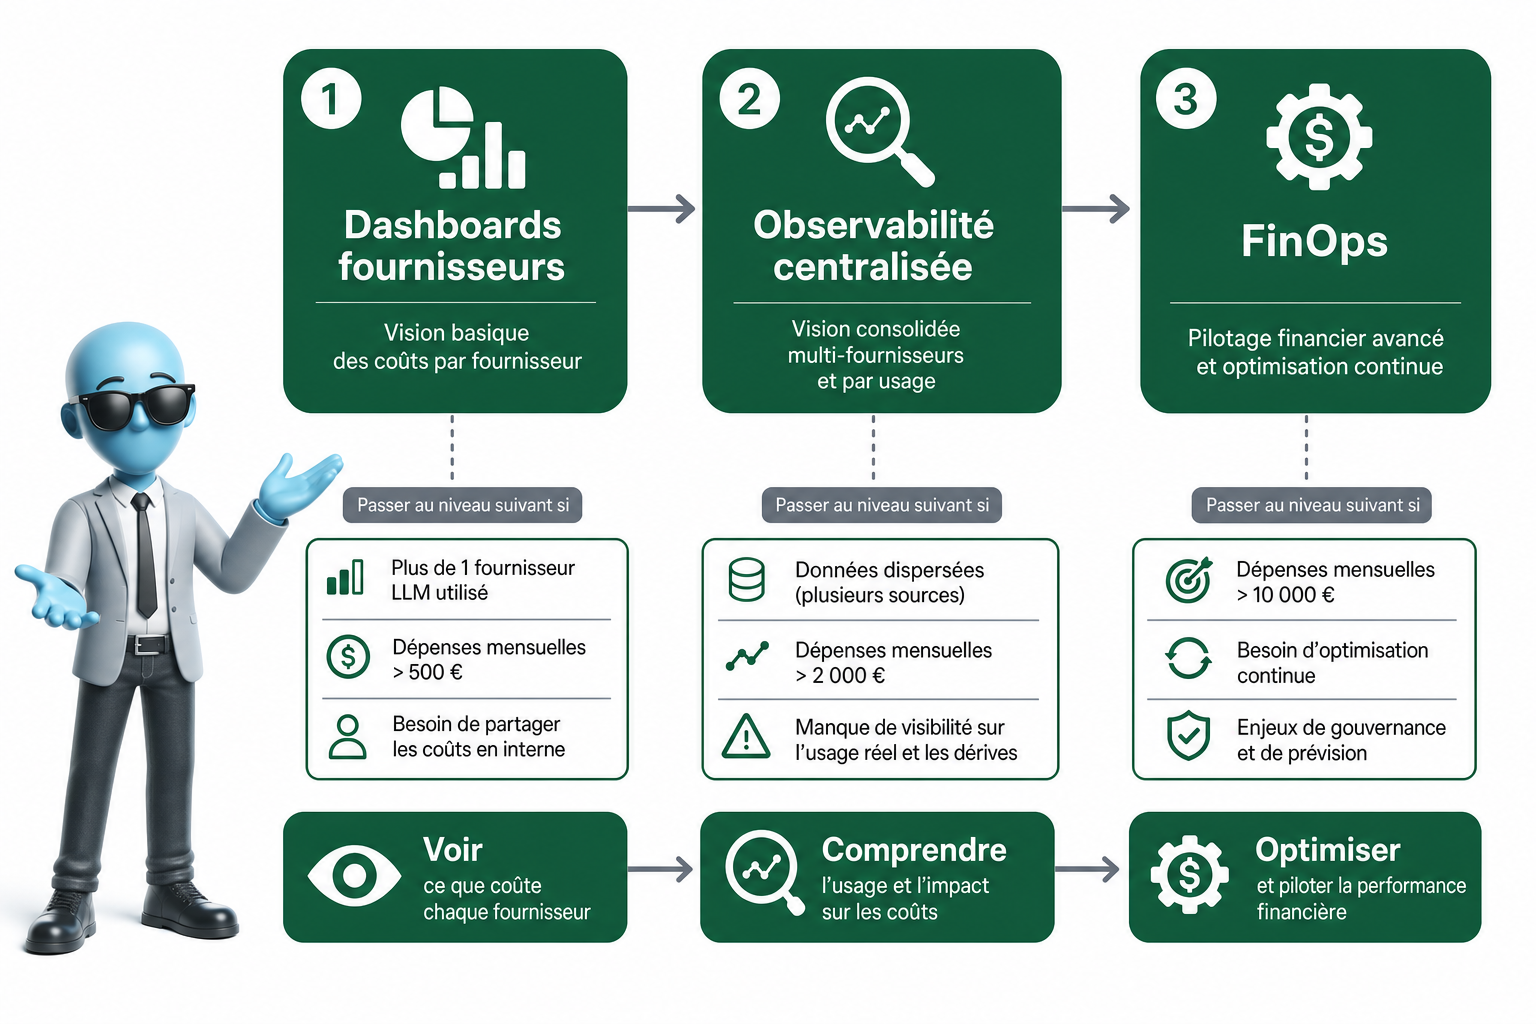
Je vois souvent la même erreur chez les équipes : elles achètent une plateforme avant d’avoir clarifié les questions à résoudre. Qui consomme ? Pour quel produit ? Sur quel client ? Avec quel modèle ? Et est-ce que le coût vient des prompts, des réponses, du retry, du RAG, ou d’un mauvais choix de modèle ? Tant que ces dimensions ne sont pas claires, l’outil ne fera que produire de jolis graphiques flous.
Pour les petits budgets, les dashboards éditeurs suffisent souvent. Les consoles OpenAI, Azure OpenAI ou Anthropic donnent déjà une vue globale de la consommation. C’est rarement parfait, mais ça permet de suivre une tendance. À condition d’ajouter un minimum de tagging côté application : un nom d’équipe, un produit, un environnement, parfois un client ou un cas d’usage.
Quand la dépense monte, je préfère centraliser. Un proxy LLM, une gateway, ou un outil d’observabilité comme Langfuse, LangSmith ou Helicone aide à tracer les appels, suivre les tokens, comparer les modèles, analyser les prompts et poser des alertes. OpenTelemetry peut aussi être utile si l’organisation veut garder une couche standardisée d’instrumentation. OpenTelemetry, c’est un standard pour collecter des traces, métriques et logs sans être enfermé dans un seul outil.
Pour les gros budgets, on bascule dans une logique FinOps. Là, il faut de l’attribution fine, des budgets par équipe, des alertes d’anomalie, des prévisions, une gouvernance des modèles et des revues régulières. Les outils FinOps ou cloud cost management deviennent pertinents quand le sujet dépasse l’équipe IA et touche la finance, la plateforme, les produits et les achats.
| Niveau de dépense | Outil adapté | Avantage | Limite | Signal qu’il faut passer au niveau supérieur |
| Petit budget | Consoles fournisseurs OpenAI, Azure OpenAI, Anthropic + tagging simple | Rapide à mettre en place, suffisant pour voir la tendance | Attribution limitée par produit, équipe ou client | Vous ne savez plus expliquer qui consomme quoi |
| Budget intermédiaire | Proxy LLM, gateway, Langfuse, LangSmith, Helicone, OpenTelemetry | Centralise les appels, trace les prompts, suit les tokens et les coûts | Demande une vraie discipline d’instrumentation | Les alertes arrivent trop tard ou les coûts varient sans explication claire |
| Budget élevé | Approche FinOps, cloud cost management, gouvernance modèles | Budgets, prévisions, anomalies, arbitrages entre équipes | Plus lourd à piloter, besoin de rituels réguliers | La dépense LLM devient un sujet de comité budget |
Mon réflexe est simple : je commence par les dimensions d’attribution, puis je choisis l’outil qui les collecte proprement. Pas l’inverse.
Comment garder les coûts sous contrôle ?
Le contrôle durable repose sur un monitoring continu, des alertes utiles et des revues régulières, pas sur un audit fait une fois puis oublié. J’ai vu trop d’équipes faire un gros nettoyage, réduire la facture pendant deux semaines, puis repartir dans le flou complet parce que personne ne regarde les signaux faibles.
Chaque semaine, je regarde ce qui dérape. Les anomalies de volume, les features qui montent trop vite, les retries, c’est-à-dire les appels relancés automatiquement après une erreur, les changements de prompts et les agents qui consomment trop. Un agent IA, c’est souvent une boucle qui réfléchit, appelle des outils, relance une étape, puis recommence. C’est puissant, mais sans limite, ça peut brûler du budget très vite.
Chaque mois, je prends un peu plus de recul. Je revois les coûts par équipe, par tâche et par modèle. Je challenge les usages des modèles les plus chers. Est-ce qu’on a vraiment besoin d’un modèle premium pour résumer trois lignes ? Souvent non. Je vérifie aussi le cache, donc la capacité à réutiliser une réponse déjà calculée quand la demande est identique ou très proche. Puis je compare le coût à la valeur business. Si une automatisation coûte 800 euros par mois mais économise 40 heures, ça se défend. Si elle génère surtout du confort flou, je coupe ou je simplifie.
Chaque trimestre, je revois la gouvernance. Les modèles autorisés, les budgets par équipe, les règles de fallback, c’est-à-dire le modèle de secours si le premier échoue ou coûte trop cher, les limites de sortie, les optimisations de prompts et le routing. Le routing, c’est envoyer chaque tâche vers le bon modèle, pas forcément le plus puissant.
Les alertes utiles sont assez simples à poser :
- Hausse brutale du nombre d’appels.
- Hausse du coût par tâche.
- Baisse du cache hit rate, donc du taux de réponses servies depuis le cache.
- Montée des retries.
- Sortie moyenne trop longue.
- Usage d’un modèle premium hors cas validé.
- Boucle d’agent détectée.
- Coût journalier au-dessus d’un seuil.
Quand une alerte tombe, je cherche une correction concrète, pas une réunion de plus. Je limite la longueur de sortie. Je réduis le contexte inutile. Je route les tâches simples vers des modèles moins chers. J’active le caching quand ça a du sens. Je limite les retries, je pose des timeouts, je journalise les versions de prompts et je bloque les boucles d’agents avec un nombre maximal d’étapes.
Le bon pilotage ne cherche pas seulement à réduire la facture. Il cherche à garder les bons usages IA, ceux qui créent vraiment de la valeur, et à couper le bruit.
Et si votre facture LLM devenait enfin pilotable ?
Auditer la dépense LLM, ce n’est pas juste regarder un total en fin de mois. C’est comprendre qui consomme, pourquoi, avec quel modèle, quel prompt, quel volume de tokens et quel niveau de valeur derrière. Je commence toujours par l’attribution, puis je sépare les types de tokens, les retries, le cache, les agents et les coûts par tâche. Ensuite seulement je choisis l’outil adapté. Dashboard fournisseur, proxy, observabilité ou FinOps, le bon choix dépend du niveau de dépense. Le bénéfice pour vous est simple : moins de surprises, moins de gaspillage, et une IA qui reste rentable.
FAQ
- Pourquoi auditer la dépense LLM ?
Parce qu’une facture LLM peut monter très vite sans que le volume utilisateur soit le seul responsable. Les tokens de sortie, les prompts trop longs, les retries, le cache mal utilisé et les boucles d’agents peuvent créer des coûts invisibles si rien n’est attribué par usage. - Quels indicateurs suivre en priorité ?
Je regarde d’abord les tokens d’entrée, les tokens de sortie, le nombre d’appels, le coût par feature, le coût par tâche, les retries, le taux de cache et le modèle utilisé. Ces indicateurs montrent vite si le problème vient du volume, du design produit ou d’un mauvais choix de modèle. - Un dashboard fournisseur suffit-il pour contrôler les coûts LLM ?
Il suffit parfois pour un petit budget ou une première lecture globale. Mais dès qu’il faut attribuer les coûts à une équipe, une feature ou un prompt, il faut ajouter du tagging applicatif, un proxy LLM, une plateforme d’observabilité ou une approche FinOps plus structurée. - Comment réduire les coûts sans dégrader la qualité ?
Je commence par supprimer le gaspillage : contexte inutile, sorties trop longues, retries excessifs, agents sans limite, modèles premium utilisés pour des tâches simples. Ensuite je teste le routing vers des modèles moins chers et le caching quand les requêtes s’y prêtent. - À quelle fréquence faut-il revoir les dépenses LLM ?
Je recommande un suivi hebdomadaire des anomalies, une revue mensuelle des coûts par équipe et par usage, puis une revue trimestrielle de la gouvernance des modèles. C’est ce rythme qui évite de découvrir les dérives uniquement au moment de la facture.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en Tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes qui veulent mesurer proprement, automatiser sans bricoler et piloter leurs coûts IA avec des données fiables. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. J’ai travaillé pour des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Si vous voulez cadrer vos usages LLM et reprendre la main sur vos coûts, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.