
Crawling ou scraping quelle différence ?
Le scraping extrait des données sur une page précise. Le crawling part d’une URL puis suit les liens pour explorer plusieurs pages. C’est la différence la plus simple à garder en tête.
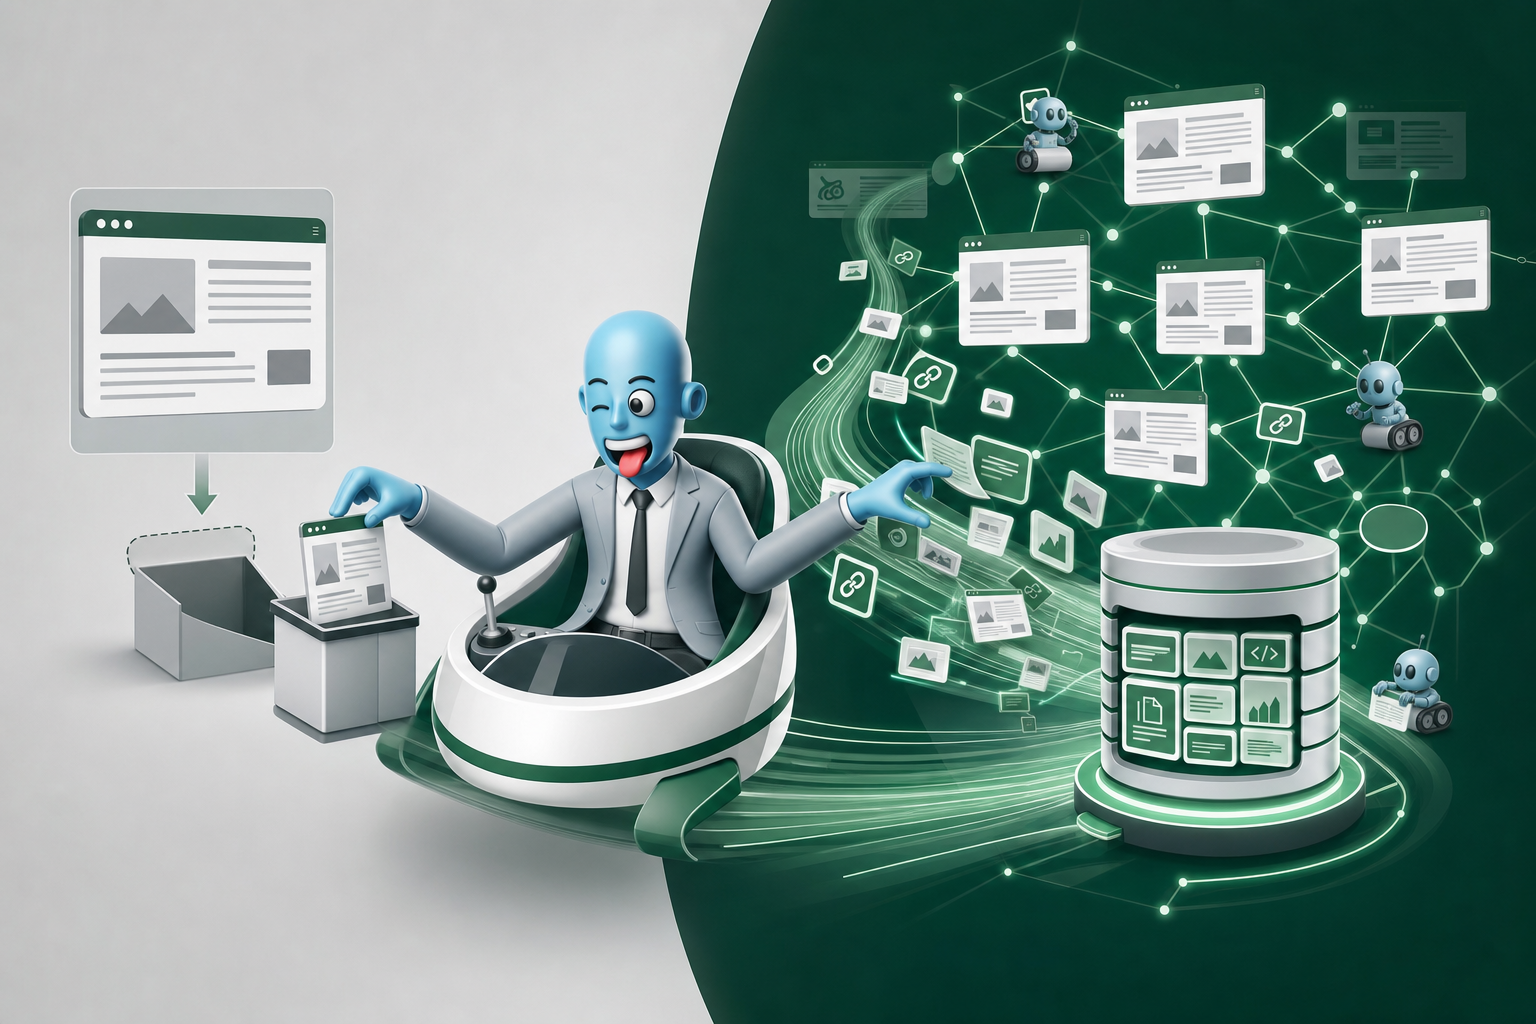
Si je récupère le prix, le titre et les avis d’une fiche produit, je fais du scraping. Je cible une page, ou un modèle de page, et je prends des champs précis. Si je pars de la page d’accueil d’une documentation, puis que je parcours toutes les pages liées pour construire une base complète, là je fais du crawling. Même logique pour un centre d’aide, une base de connaissances, un blog entier ou un catalogue avec pagination.
Les outils modernes ne se contentent plus de télécharger du HTML brut. Ils nettoient le contenu, retirent les menus, les pubs, les footers, puis sortent du Markdown ou du JSON directement exploitable. Le Markdown, c’est un format texte simple, très pratique pour les modèles IA. Le JSON, c’est un format structuré, parfait pour envoyer les données dans une API, une base ou un workflow d’automatisation.
Certains outils prennent aussi des captures d’écran, exécutent le JavaScript, attendent qu’une page soit chargée, ou acceptent des prompts d’extraction. En clair, je peux leur dire “récupère les tarifs, les conditions et les limites de cette offre” au lieu de coder chaque sélecteur CSS à la main. C’est aussi pour ça qu’on les retrouve de plus en plus dans des agents IA et des pipelines RAG. RAG veut dire Retrieval Augmented Generation. C’est le fait de donner à une IA une base documentaire fiable avant qu’elle réponde.
J’ai souvent vu des équipes confondre les deux. Et ça finit avec des scripts fragiles qui cassent au premier changement de layout. Le vrai sujet, ce n’est pas “quel outil est le plus puissant”. C’est plutôt : Est-ce que je veux une donnée ponctuelle, ou une base de contenu réutilisable dans le temps ?
Quelques règles évitent pas mal d’ennuis :
- Respecter robots.txt quand c’est pertinent, surtout sur des sites publics ou sensibles.
- Limiter la fréquence des requêtes pour ne pas surcharger le serveur.
- Identifier son crawler avec un User-Agent clair quand on industrialise.
- Éviter de collecter des données personnelles sans base légale.
- Surveiller les erreurs HTTP comme 403, 404, 429 ou 500.
- Prévoir les limites de débit, les retries et les pauses.
- Documenter les sources crawlées, la date, le périmètre et l’usage prévu.
| Approche | Usage | Périmètre | Sortie attendue | Complexité | Exemple business |
| Scraping | Extraire des champs précis | Une page ou un type de page | Prix, titre, avis, stock, contact | Moyenne, surtout si le layout change | Suivre les prix concurrents sur des fiches produit |
| Crawling | Explorer et indexer du contenu | Un site, une documentation, un centre d’aide | Markdown, JSON, pages nettoyées, captures | Plus élevée, car il faut gérer les liens, erreurs et limites | Créer une base documentaire pour un chatbot IA |
Quelles API IA choisir en premier ?
Pour un usage IA rapide, je regarderais d’abord Olostep et Firecrawl, parce qu’ils renvoient du contenu propre depuis une URL de départ sans devoir maintenir toute l’infrastructure soi-même.
Olostep est pensé pour crawler des sous-pages liées et produire un contenu directement exploitable dans des workflows IA. Je le trouve intéressant sur des contenus comme une documentation, un blog, des pages produit, un centre d’aide ou une base de connaissances. C’est typiquement le genre d’outil que je regarde quand je veux un bon équilibre entre coût, vitesse et précision, sans passer trois jours à gérer les erreurs de crawl. Le côté développeur est aussi assez pratique, avec des intégrations comme la CLI, les MCP servers, et les skills d’agents. MCP, pour faire simple, c’est une façon de connecter proprement des outils externes à des agents IA.
Firecrawl est plus connu dans l’écosystème IA. Son usage principal est clair : transformer un site web en contenu propre pour des LLM, du RAG, des agents IA ou de la recherche interne. RAG veut dire Retrieval Augmented Generation, c’est le fait d’aller chercher des documents fiables avant de faire répondre un modèle IA. Je ne mettrais pas un vainqueur absolu entre Olostep et Firecrawl. Selon le site, la structure HTML, le JavaScript, le format de sortie attendu et votre tolérance aux erreurs, l’un peut être plus pratique que l’autre.
Ce petit exemple sert à tester une API de crawl sans s’enfermer dans un fournisseur précis. Il faut remplacer API_URL par l’endpoint officiel de l’outil choisi.
import requests

API_URL = "https://api.example.com/crawl"  # Remplacer par l'endpoint officiel
API_KEY = "VOTRE_CLE_API"

start_url = "https://example.com/docs"

payload = {
    "url": start_url,
    "format": "markdown"
}

headers = {
    "Authorization": f"Bearer {API_KEY}",
    "Content-Type": "application/json"
}

response = requests.post(API_URL, json=payload, headers=headers)
response.raise_for_status()

data = response.json()

clean_content = data.get("markdown") or data.get("text", "")

with open("crawl_result.md", "w", encoding="utf-8") as file:
    file.write(clean_content)
La sortie idéale ressemble souvent à ça. Cette structure est utile pour indexer ensuite les contenus dans une base vectorielle, c’est-à-dire une base qui permet de retrouver des textes par similarité sémantique.
{
  "url": "https://example.com/docs/page",
  "title": "Titre de la page",
  "markdown": "# Contenu propre",
  "links": ["https://example.com/docs/next"],
  "screenshot_url": "https://example.com/screenshot.png",
  "metadata": {
    "language": "fr",
    "status_code": 200,
    "crawl_date": "2026-01-15"
  }
}| Critère | Olostep | Firecrawl |
| Meilleur usage | Docs, blogs, centres d’aide, bases de connaissances | Sites à convertir pour LLM, RAG, agents et recherche interne |
| Type de sortie | Contenu propre orienté workflows IA | Markdown, texte propre et données structurées selon configuration |
| Intérêt pour RAG | Très bon pour créer vite un corpus exploitable | Très bon aussi, avec une forte adoption côté IA |
| Niveau de maintenance | Faible, l’API absorbe une grosse partie du crawl | Faible, surtout si le site est bien supporté |
| Point d’attention | Tester la profondeur de crawl et les formats nécessaires | Tester le rendu JavaScript et la stabilité sur votre site cible |
Quand choisir un crawler open source ?
Je choisis l’open source quand j’ai besoin de contrôle, de confidentialité, de coûts maîtrisés à grande échelle ou d’un comportement très spécifique. C’est souvent le bon choix quand vos données sont sensibles, quand le volume explose, ou quand un outil SaaS vous bloque avec ses limites.
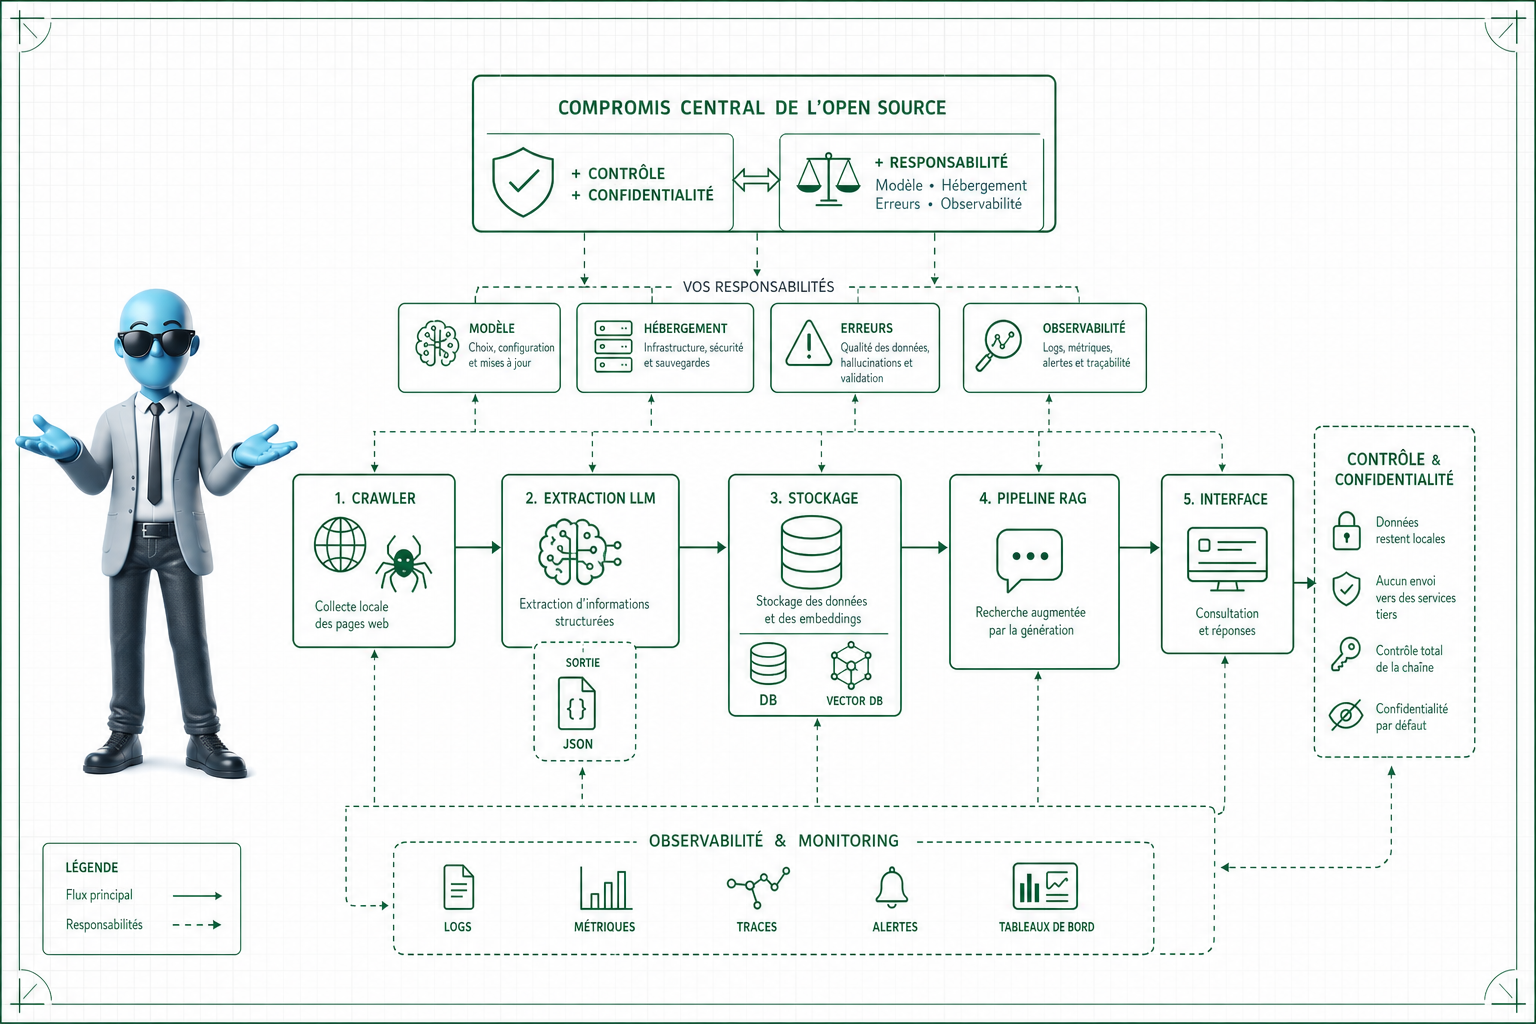
ScrapeGraphAI est intéressant dans ce cas. C’est une solution open source qui combine des LLMs, donc des modèles de langage comme GPT, Mistral ou Llama, avec une logique de graphes pour extraire des données depuis des sites web ou des fichiers locaux. Le compromis est clair : j’ai plus de contrôle, mais je dois fournir et configurer mon propre modèle IA, via API ou en local. En échange, je peux faire de l’extraction, du crawl multi-pages, de la recherche et même du monitoring. Sur un projet client, c’était utile pour extraire des fiches produits très irrégulières, là où un scraper classique cassait toutes les deux pages.
Crawl4AI joue dans la même famille, avec une approche open source gratuite à exécuter soi-même, plutôt orientée usages IA. Je reste prudent sur les options exactes, parce que ça bouge vite, donc je vérifie toujours la documentation officielle avant de partir en production. L’intérêt est simple : générer du contenu propre pour un LLM, produire du Markdown, automatiser l’extraction et brancher le résultat dans un pipeline RAG, c’est-à-dire un système qui donne à l’IA vos propres documents comme contexte.
Voici un crawler local minimal. Il sert à comprendre la mécanique, pas à remplacer ScrapeGraphAI, Crawl4AI ou un vrai système de crawl distribué.
import json
from urllib.parse import urljoin, urlparse

import httpx
from bs4 import BeautifulSoup

START_URL = "https://example.com"
DOMAIN = urlparse(START_URL).netloc
seen = set()
results = []

def clean(text):
    return " ".join(text.split())

def crawl(url, limit=10):
    if url in seen or len(seen) >= limit:
        return

    seen.add(url)
    response = httpx.get(url, timeout=10)
    soup = BeautifulSoup(response.text, "html.parser")

    title = clean(soup.title.text) if soup.title else ""
    paragraphs = [clean(p.get_text()) for p in soup.find_all("p")]
    paragraphs = [p for p in paragraphs if p]

    results.append({
        "url": url,
        "title": title,
        "content": paragraphs
    })

    for a in soup.find_all("a", href=True):
        link = urljoin(url, a["href"])
        if urlparse(link).netloc == DOMAIN:
            crawl(link, limit)

crawl(START_URL)

with open("crawl.json", "w", encoding="utf-8") as f:
    json.dump(results, f, ensure_ascii=False, indent=2)
Ensuite, je peux ajouter une extraction par prompt. Le principe est d’envoyer le contenu nettoyé au LLM avec une consigne stricte, puis de valider le JSON côté code avant ingestion.
prompt = f"""
Retourne uniquement un JSON valide avec ce schéma :
name, description, pricing, features.

Contenu :
{cleaned_content}
"""

# Réponse attendue du LLM :
# {
#   "name": "...",
#   "description": "...",
#   "pricing": "...",
#   "features": ["...", "..."]
# }

# À faire avant ingestion :
# Valider que les clés existent, que le JSON est valide,
# et que features est bien une liste.
L’open source est séduisant, oui. Mais il faut gérer l’hébergement, les mises à jour, les proxys, les erreurs, les files d’attente et l’observabilité. C’est rarement gratuit en temps humain.
Quel framework Python pour crawler sérieusement ?
Pour un crawler Python solide, je regarderais Scrapling si je veux un framework moderne avec parsing adaptatif, et Scrapy si je veux une base très mature pour industrialiser.
Scrapling est un framework open source Python capable de partir d’une seule page, puis de monter vers un vrai crawl complet. Son gros point fort, c’est son parser adaptatif. En clair, il aide votre extraction à survivre quand le site change un peu sa mise en page. Et ça arrive tout le temps. J’ai déjà vu des crawlers tomber juste parce qu’un bloc produit passait de div à section.
Avec Scrapling, je regarde surtout les fetchers, les spiders, le crawl concurrent, la reprise après pause et la rotation automatique des proxys. C’est pratique quand on veut garder la main. Mais il y a une réalité derrière : il faut l’héberger, le monitorer, gérer les erreurs, les proxys, les logs, les mises à jour. Rien n’est magique.
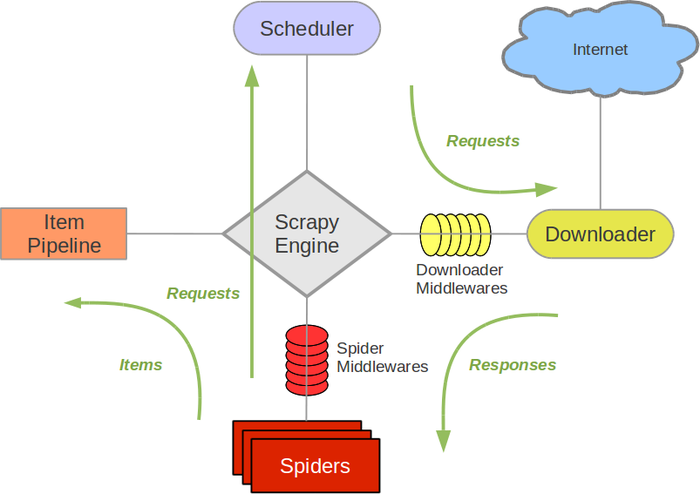
Scrapy, lui, c’est le framework Python historique pour crawler sérieusement à grande échelle. Il repose sur des spiders, des selectors pour extraire les données, des item pipelines pour nettoyer ou stocker, du middleware pour modifier les requêtes, une gestion des erreurs, du throttling pour ralentir le crawl, et le respect optionnel de robots.txt selon votre configuration. Scrapy est moins orienté LLM par défaut, mais pour construire une collecte robuste, il reste excellent.
Voici un spider Scrapy simple. Il part d’une URL, extrait le titre, un extrait de texte, suit les liens internes, puis retourne un item propre.
import scrapy
from urllib.parse import urlparse

class SimpleSpider(scrapy.Spider):
    name = "simple_spider"
    start_urls = ["https://example.com"]

    def parse(self, response):
        # Parse est appelée pour chaque page reçue
        title = response.css("title::text").get(default="").strip()

        # Response.css utilise des sélecteurs CSS pour extraire du contenu
        text = " ".join(response.css("body ::text").getall()).strip()

        yield {
            "url": response.url,
            "title": title,
            "text_excerpt": text[:500]
        }

        domain = urlparse(response.url).netloc

        for href in response.css("a::attr(href)").getall():
            # Response.follow construit une nouvelle requête depuis un lien
            next_request = response.follow(href, callback=self.parse)

            if next_request and urlparse(next_request.url).netloc == domain:
                # Yield envoie soit un item, soit une nouvelle requête à Scrapy
                yield next_request
En production, je garde une architecture simple : file de jobs, crawler, stockage brut, nettoyage, sortie JSON ou Markdown, indexation, monitoring. Les API managées vues avant cachent cette complexité. Les frameworks comme Scrapy ou Scrapling vous donnent la main dessus.
| Critère | Scrapling | Scrapy |
| Courbe d’apprentissage | Moyenne | Moyenne à élevée |
| Robustesse | Bonne | Très forte |
| Adaptation aux layouts | Très bonne grâce au parsing adaptatif | Manuelle, mais précise |
| Maturité | Plus récent | Très mature |
| Besoin DevOps | Oui | Oui |
| Meilleur usage | Crawls modernes avec pages qui bougent | Collecte industrielle stable |
Comment choisir selon votre cas d’usage ?
Je choisis l’outil en partant du résultat attendu, pas de la popularité de l’outil. Si la sortie doit nourrir un LLM, une base vectorielle ou un agent, le format et la propreté du contenu comptent plus que le nombre de pages crawlées. J’ai vu des projets RAG échouer avec un très bon modèle, juste parce que le crawl ramenait des menus, des footers, des doublons et du Markdown sale.
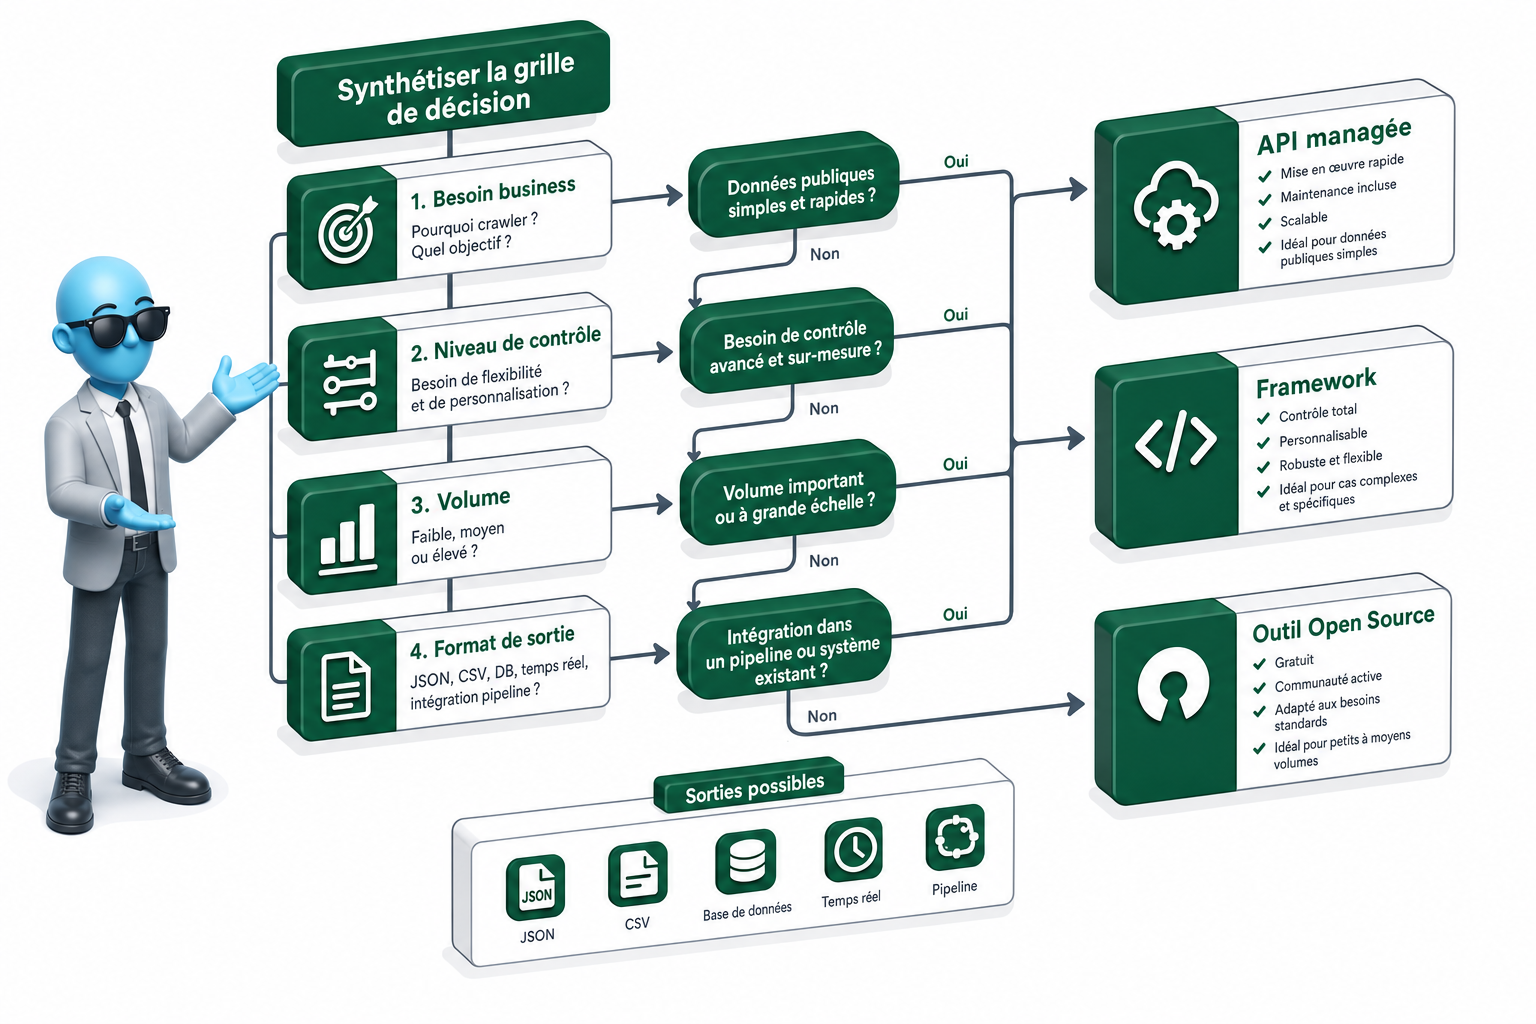
Ma grille est assez simple. Pour aller vite avec une API IA, je regarde Olostep ou Firecrawl. Pour garder le contrôle avec un LLM local ou une extraction avancée, je pars plutôt sur ScrapeGraphAI ou Crawl4AI. Pour crawler en Python avec de la logique métier, Scrapling ou Scrapy restent solides. Pour un environnement JavaScript ou TypeScript robuste, Crawlee est un très bon choix, open source, souvent utilisé avec Playwright ou Puppeteer pour construire des crawlers fiables sur des sites modernes.
Les critères à regarder avant de choisir sont concrets :
- Le rendu JavaScript, si le contenu arrive après chargement dans le navigateur.
- La qualité du Markdown, surtout pour du RAG.
- L’extraction JSON structurée, quand on veut des champs propres.
- La gestion des liens, la profondeur de crawl, la vitesse et le coût par page.
- Les proxys, l’observabilité, la reprise sur erreur et la conformité.
- L’intégration RAG, l’intégration agent IA et la facilité de déploiement.
Un pipeline RAG complet ressemble souvent à ça : crawl des pages, nettoyage du contenu, découpage en chunks, enrichissement avec des métadonnées, création des embeddings, stockage dans une base vectorielle, recherche sémantique, puis réponse du LLM avec citations. Le point dur, c’est le début. Un mauvais crawl pollue tout le pipeline. Même le meilleur modèle ne devine pas ce qui a été mal extrait.
| Outil | Type | Hébergement | Meilleur usage | Avantage principal | Point d’attention |
| Olostep | API IA | Managé | Extraction rapide | Simple à intégrer | Coût au volume |
| Firecrawl | API crawl/RAG | Managé | Markdown pour LLM | Très orienté IA | Moins flexible qu’un framework |
| ScrapeGraphAI | Framework IA | Local ou serveur | Extraction avec LLM | Contrôle fin | Setup plus technique |
| Scrapling | Python crawler | Local ou serveur | Logique métier | Souple en Python | À maintenir soi-même |
| Crawl4AI | Crawler IA | Local ou serveur | RAG open source | Bon contrôle du contenu | Demande des tests |
| Crawlee | Framework JS/TS | Local ou cloud | Crawlers robustes | Open source, fiable | Courbe d’apprentissage |
| Scrapy | Framework Python | Local ou serveur | Crawl à grande échelle | Très mature | JavaScript à gérer à part |
Ma recommandation nette : je commence par une API managée pour valider la valeur business vite. Si le volume, la confidentialité ou la personnalisation le justifient, je bascule ensuite vers de l’open source ou un framework plus contrôlable.
Alors vous partez sur quel crawler ?
Le bon outil de web crawling dépend surtout de ce que vous voulez produire derrière. Pour alimenter un LLM ou un RAG rapidement, je partirais sur une API comme Olostep ou Firecrawl. Pour garder la main, ScrapeGraphAI, Crawl4AI, Scrapling, Crawlee ou Scrapy deviennent plus intéressants, avec plus de configuration et plus de maintenance. Le piège, c’est de choisir un outil parce qu’il est à la mode. Je préfère partir du besoin : contenu propre, JSON structuré, volume, coût, conformité, intégration IA. Vous gagnez du temps, vous réduisez la casse, et vos données deviennent vraiment exploitables.
FAQ
- Quelle est la différence entre web crawling et web scraping ?
Le scraping extrait des données sur une page précise. Le crawling explore plusieurs pages en suivant les liens depuis une URL de départ. En pratique, le crawling sert souvent à construire une base de contenu plus large, par exemple une documentation, un blog ou un centre d’aide. - Quel outil choisir pour alimenter un LLM ou un RAG ?
Je regarderais d’abord les API orientées IA comme Olostep ou Firecrawl, parce qu’elles produisent du contenu propre, souvent en Markdown ou JSON. C’est plus rapide pour tester un cas d’usage RAG avant d’investir dans une architecture plus lourde. - Un crawler open source est-il vraiment moins cher ?
Pas toujours. La licence peut être gratuite, mais il faut gérer l’hébergement, les erreurs, les proxys, les mises à jour, le monitoring et parfois les modèles IA. L’open source devient intéressant quand vous avez besoin de contrôle, de volume ou de confidentialité. - Scrapy est-il encore utile en 2026 ?
Oui, surtout pour construire des crawlers Python robustes et industrialisables. Scrapy n’est pas le plus orienté IA par défaut, mais il reste très solide pour gérer des spiders, des pipelines, des middlewares, du throttling et des crawls à grande échelle. - Quels critères regarder avant de choisir un outil de web crawling ?
Je regarde d’abord la qualité de sortie, le rendu JavaScript, la profondeur de crawl, le coût, la vitesse, la reprise sur erreur, les formats JSON ou Markdown, l’intégration avec un pipeline IA, et la maintenance nécessaire. Le meilleur outil est celui qui colle à votre usage réel.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes qui veulent transformer leurs données web en vrais actifs business, pas en tableaux inutilisables. J’ai travaillé pour des clients comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. Si vous voulez cadrer un projet de crawling, RAG, tracking ou automatisation IA, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.