
J’intègre la gouvernance de l’IA dès la conception, puis je la prolonge dans les pipelines MLOps et le suivi en production. Vous verrez comment traiter la confidentialité, l’explicabilité et les contrôles continus sans réduire la gouvernance à une validation finale.
Pourquoi intégrer la gouvernance dès la conception ?
La gouvernance de l’IA doit être intégrée dès la conception parce qu’une vérification finale ne suffit pas à orienter les choix effectués pendant le développement. Elle doit accompagner le cycle de développement, et pas seulement intervenir une fois le système construit. C’est à cette condition que les préoccupations liées aux données personnelles peuvent être prises en compte au fil des décisions, plutôt que traitées comme un contrôle isolé.
L’adoption progresse rapidement. Selon l’AI Index 2025 de Stanford, 78 % des entreprises ont adopté l’IA en 2024, contre 55 % en 2023. Mais l’intégration de la gouvernance ne suit pas nécessairement le même rythme. Selon l’AI Governance Index de Trustmarque, 93 % des organisations britanniques utilisent l’IA, mais seulement 8 % ont entièrement intégré sa gouvernance au cycle de développement.
Cet écart met en évidence un enjeu concret : l’utilisation de l’IA se diffuse, alors que sa gouvernance reste rarement intégrée de bout en bout. Les préoccupations concernant les données personnelles rendent cette intégration particulièrement importante. Les exigences du RGPD et du CCPA doivent être prises en compte dans la gouvernance des systèmes d’IA, sans réduire celle-ci à une vérification effectuée à la fin du projet.
Intégrer la gouvernance dès la conception ne signifie pas renoncer à expérimenter. Il s’agit de conserver cette capacité tout en protégeant la vie privée et en renforçant la confiance. Une gouvernance pensée pendant le développement permet de relier ces objectifs aux choix qui façonnent le système, plutôt que de les confronter après coup.
La première étape consiste donc à clarifier les décisions qui encadreront le projet avant même l’entraînement : quelles données seront utilisées, et quels critères guideront leur sélection ?
Comment protéger les données dès la préparation ?
Je protège les données dès l’ingénierie des caractéristiques, avant l’entraînement du modèle. À cette étape, je vérifie ce que chaque donnée apporte réellement à l’objectif du système. Une donnée personnelle sans contribution claire est un candidat à la suppression ou à la transformation.
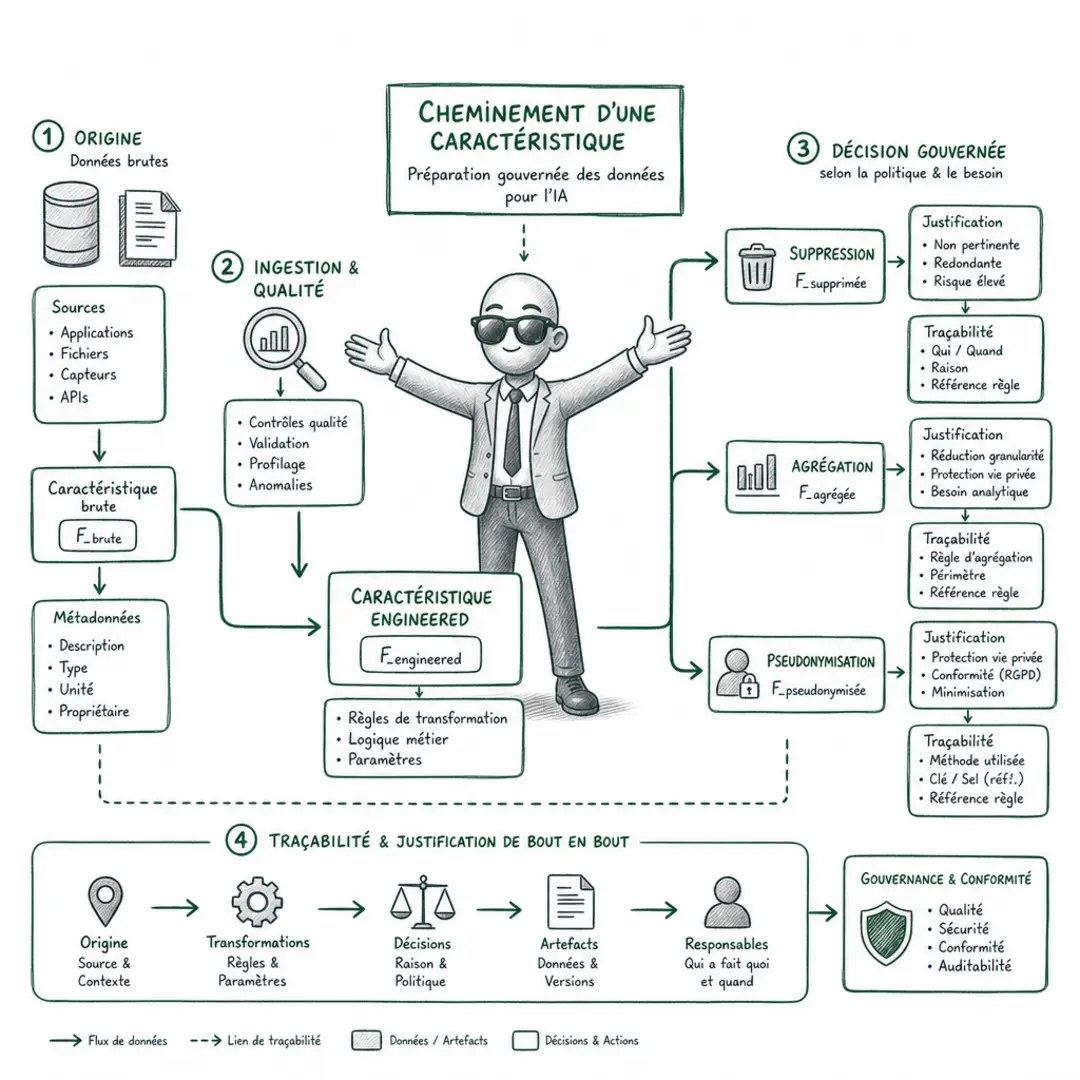
Pour chaque caractéristique, je relie sa présence à l’usage prévu. Si elle n’apporte pas d’information utile à cet usage, je la retire du jeu de données. Si elle peut être remplacée par une représentation moins exposante, je la transforme. Deux options sont possibles, selon le besoin :
- L’agrégation remplace des données individuelles par une mesure synthétique, par exemple un total ou une moyenne. Elle réduit le niveau de détail, mais ne constitue pas une garantie absolue de confidentialité.
- La pseudonymisation remplace certains éléments identifiants par des valeurs de substitution. Elle limite leur exposition directe, sans rendre les données anonymes ni garantir à elle seule la confidentialité.
Je documente la provenance de chaque caractéristique et son objectif dans le jeu de données. Cette documentation permet de comprendre d’où vient l’information, pourquoi elle est conservée et quelle transformation elle a éventuellement subie. Elle rend les arbitrages vérifiables, y compris lorsque les besoins du projet évoluent.
Ces décisions relèvent de la gouvernance du jeu de données. Je conserve une trace des choix de conception : caractéristique supprimée, transformée ou maintenue, avec sa justification. La traçabilité évite de traiter la préparation comme une étape invisible et permet de relier la composition du jeu de données à l’usage prévu du modèle.
Une fois ces choix établis, le jeu de données peut être utilisé pour comparer les modèles. L’étape suivante consiste à choisir les modèles à évaluer et à définir comment leurs résultats seront examinés.
Comment rendre les modèles explicables ?
Je ne choisis pas un modèle uniquement parce qu’il affiche la meilleure précision. Une prédiction doit aussi pouvoir être examinée, surtout si elle influence une décision importante pour un client, un salarié ou un partenaire.
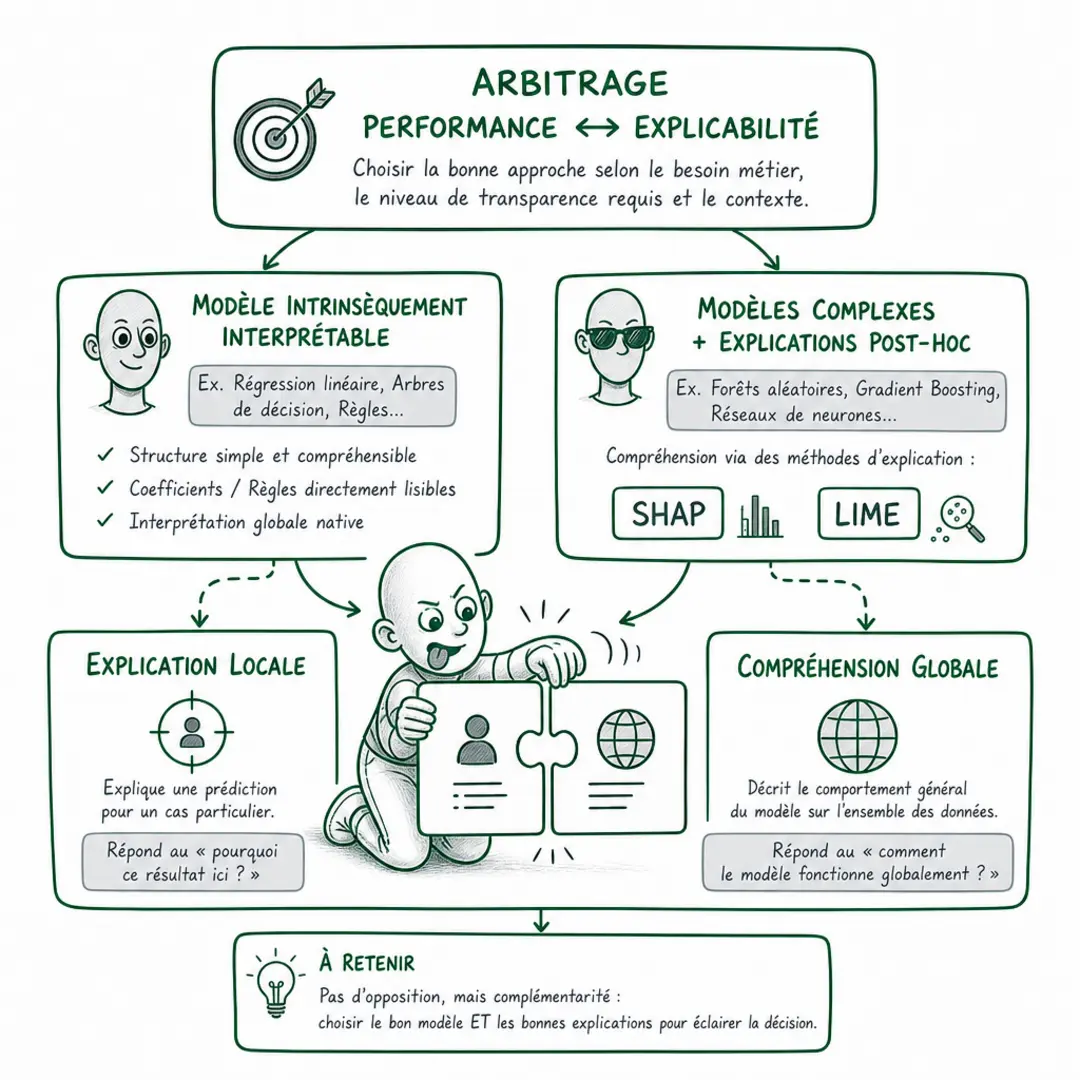
Quand les performances sont suffisantes, je privilégie un modèle intrinsèquement interprétable. Sa logique de décision est plus directement accessible à l’analyse. Si un modèle plus complexe apporte un gain de performance utile, je vérifie que ce gain justifie la difficulté supplémentaire à expliquer ses résultats. Le meilleur compromis dépend du contexte, du niveau de risque et des conséquences d’une erreur.
Pour les modèles complexes, des méthodes comme SHAP et LIME peuvent aider à examiner la contribution des caractéristiques à une prédiction. Elles donnent des éléments d’analyse, mais ne rendent pas automatiquement le modèle parfaitement compréhensible. Une explication locale, liée à une prédiction particulière, ne suffit pas nécessairement à comprendre le comportement général du modèle.
J’évalue donc l’explicabilité avant la mise en production. Cette vérification est particulièrement importante pour les décisions à fort impact. Je définis les critères de validation en amont, avec les équipes concernées : quelles décisions doivent pouvoir être expliquées, à quel niveau de détail, et quelles limites rendent le modèle impropre à l’usage prévu. Ces critères doivent être vérifiés sur des cas représentatifs, pas seulement sur les exemples où le modèle donne un résultat attendu.
Concrètement, je documente le modèle retenu, les explications produites et les limites constatées. Si les personnes chargées d’examiner les décisions ne peuvent pas exploiter ces explications, le dispositif n’est pas prêt. L’explicabilité devient ainsi un critère de mise en production, au même titre que les performances attendues.
Comment maintenir la gouvernance en production ?
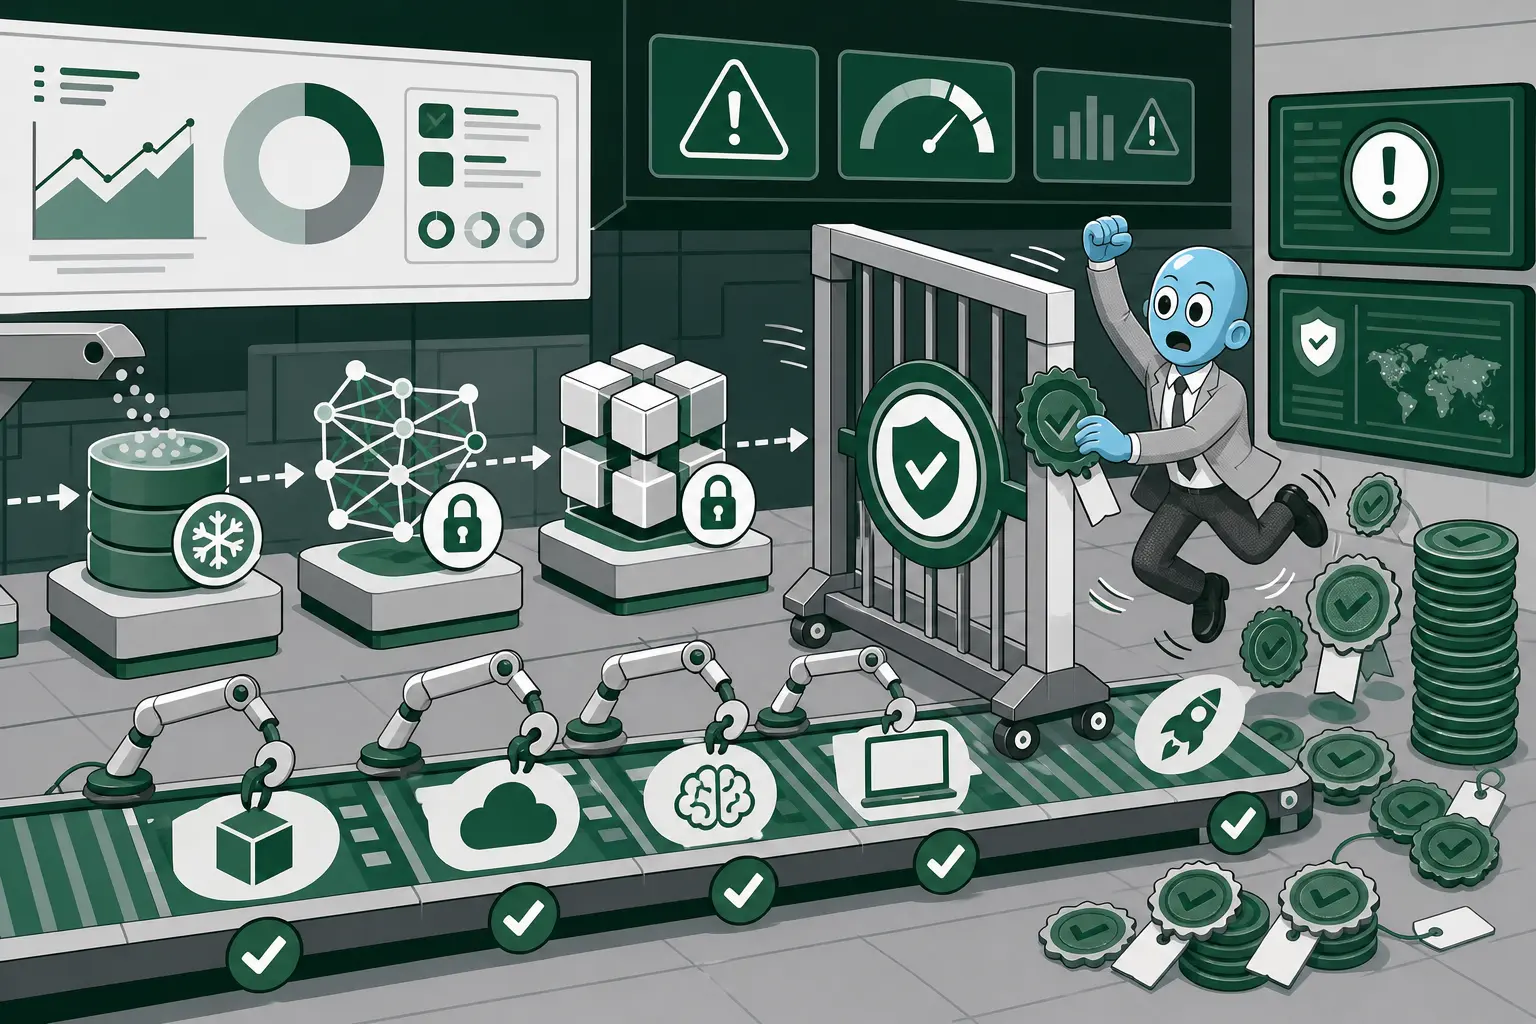
Je maintiens la gouvernance après le déploiement, car le comportement d’un modèle peut évoluer quand les données de production changent. Une validation réussie avant mise en service ne garantit donc pas des résultats fiables dans la durée. La gouvernance doit prolonger les contrôles définis lors du cadrage, de l’évaluation des risques, de la préparation des données et de la validation du modèle.
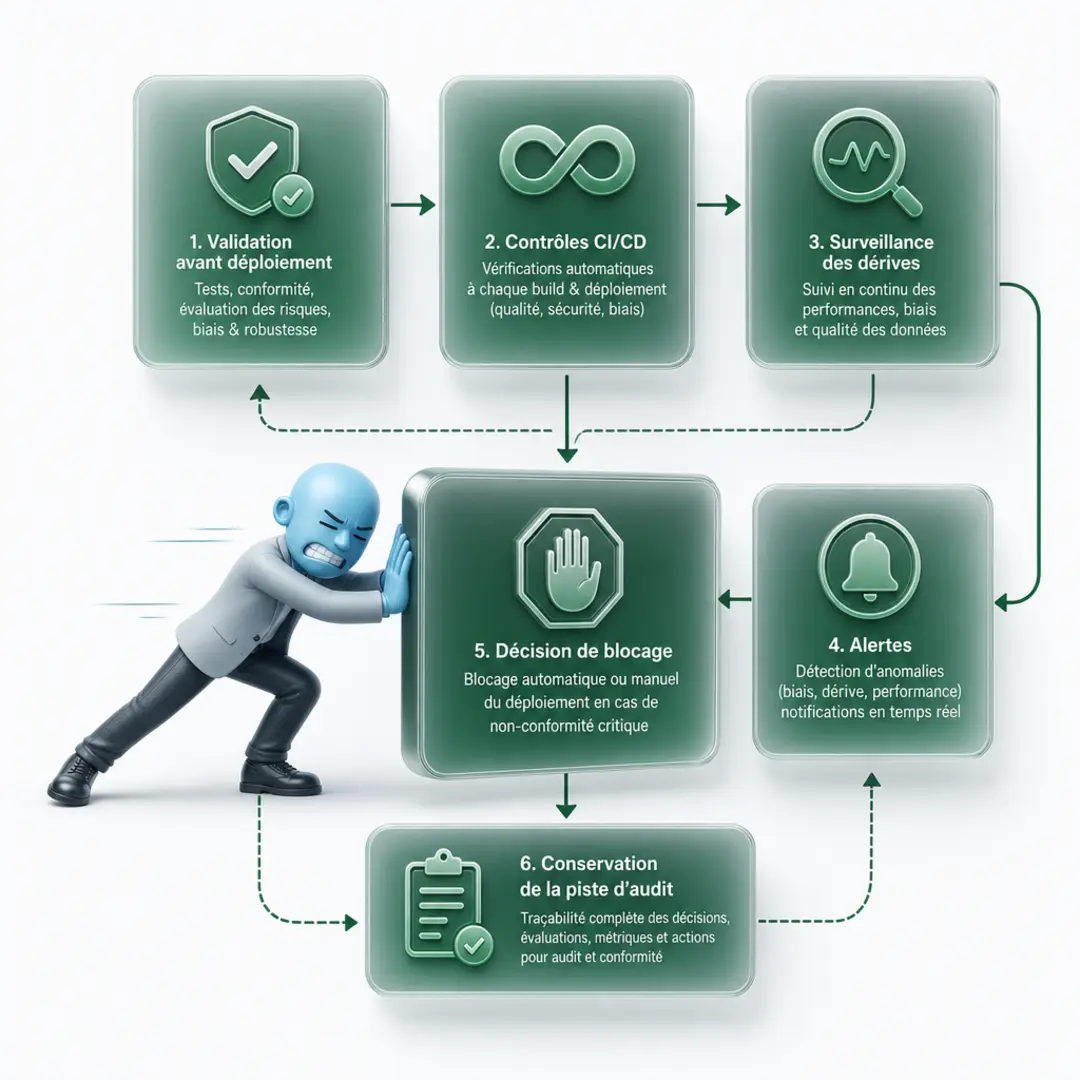
J’intègre les contrôles automatisés aux pipelines d’intégration et de livraison continues (CI/CD). Chaque nouvelle version est évaluée avant son déploiement, avec les mêmes exigences de gouvernance que lors de la validation initiale. Le pipeline bloque la mise en production si un seuil de biais défini par l’entreprise est dépassé. Ces seuils doivent être fixés en amont, selon le contexte d’usage et les obligations applicables.
Les contrôles doivent comparer les performances entre groupes démographiques pertinents, lorsque ces données peuvent être utilisées de manière appropriée. Je conserve les résultats par groupe et la décision de déploiement. Un écart ne doit pas être masqué par une moyenne globale.
En production, je surveille les données d’entrée, les prédictions et les indicateurs de performance disponibles. Des alertes signalent une dérive des données ou des prédictions anormales afin qu’une équipe puisse analyser la situation et décider d’une action. La supervision doit couvrir les étapes suivantes :
- Avant le déploiement. Enregistrer les résultats des contrôles, les seuils appliqués et la décision de validation.
- Pendant l’exploitation. Suivre les dérives et les anomalies, puis conserver les alertes et les actions engagées.
- À chaque évolution. Tracer la version du modèle, les changements apportés et les résultats de ses contrôles.
Cette continuité rend les décisions auditables et permet de relier un incident à la version concernée. Je conserve un historique exploitable des versions et une piste d’audit des validations, déploiements, alertes et interventions. Sans ces traces, on ne peut ni expliquer une évolution du comportement ni démontrer que les contrôles ont bien été appliqués.
| Étape | Contrôle de gouvernance | Trace à conserver |
| Avant le déploiement | Contrôles automatisés et comparaison des performances entre groupes démographiques. | Résultats, seuils appliqués et décision de déploiement. |
| En production | Suivi des dérives et alertes sur les prédictions anormales. | Alertes, analyses et actions engagées. |
| À chaque évolution | Contrôle de la nouvelle version et blocage si un seuil de biais défini est dépassé. | Historique des versions et piste d’audit des contrôles et déploiements. |
Comment rendre cette gouvernance opérationnelle ?
La gouvernance de l’IA devient opérationnelle quand elle accompagne le modèle de bout en bout. Avant l’entraînement, j’examine les données personnelles, leur utilité, leur transformation et la documentation des caractéristiques. Au moment du choix du modèle, je mets en balance performance et explicabilité, surtout pour les décisions à fort impact. Après le déploiement, j’intègre des contrôles automatisés, le suivi des dérives, des alertes, l’historique des versions et des pistes d’audit. Cette continuité permet de préserver l’expérimentation tout en rendant les risques plus visibles et les décisions plus traçables. Vous obtenez ainsi un cadre concret pour développer des systèmes d’IA plus maîtrisés et renforcer la confiance.
FAQ
-
Quand faut-il intégrer la gouvernance de l’IA ?
Dès la conception du système, puis à chaque étape du cycle de vie, jusqu’au suivi en production. Une vérification uniquement finale ne couvre pas les décisions prises sur les données et les modèles. -
Comment limiter l’exposition des données personnelles ?
Repérez les données personnelles inutiles avant l’entraînement, puis supprimez-les ou transformez-les. Des caractéristiques agrégées ou la pseudonymisation peuvent être envisagées. Documentez la provenance et l’objectif de chaque caractéristique. -
Faut-il toujours choisir le modèle le plus précis ?
Non. Le choix doit aussi tenir compte de l’explicabilité. Privilégiez un modèle intrinsèquement interprétable lorsqu’il offre des performances suffisantes. Pour un modèle complexe, SHAP ou LIME peuvent aider à examiner la contribution des caractéristiques. -
Comment surveiller les biais après le déploiement ?
Intégrez aux pipelines des contrôles de performance entre groupes démographiques et définissez des seuils de biais. Une version qui dépasse ces seuils peut être bloquée avant sa mise en production. -
Quels éléments suivre en production ?
Suivez les dérives et les prédictions anormales, configurez des alertes et conservez l’historique des versions ainsi que les pistes d’audit. Ces éléments soutiennent une supervision continue du modèle.
A propos de l’auteur
Franck Scandolera, expert en data engineering et en automatisation IA, accompagne l’intégration de contrôles de gouvernance dans les workflows et les applications métier intelligentes.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.